
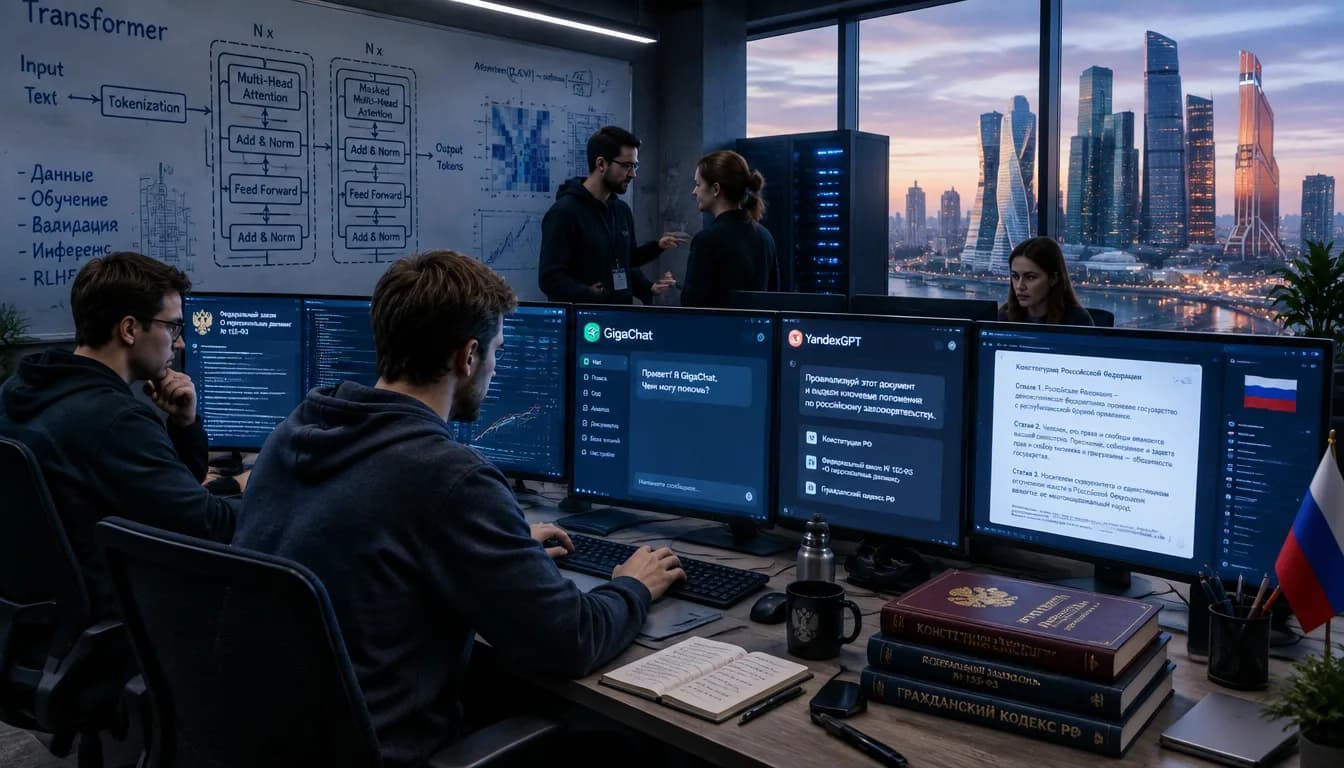
Россия входит в очень маленький клуб стран, которые умеют создавать собственные большие языковые модели с нуля. У нас есть GigaChat, модели Яндекса, генераторы изображений Kandinsky и Шедеврум. Пока большая часть Европы — за редкими исключениями вроде французской Mistral — пользуется американскими нейросетями OpenAI, Google и Anthropic, российские инженеры делают модели, которые хорошо понимают русский язык, российские законы и бытовые реалии.
Но под красивой витриной скрывается тревожная картина. По оценкам аналитиков, вычислительная мощность для ИИ в России в десятки раз меньше, чем в США, а по объёму дата-центров страна находится лишь в конце третьего десятка мирового рейтинга. Пока в Америке обсуждают инфраструктурные проекты на сотни миллиардов долларов, российские компании добывают ускорители Nvidia через третьи страны.
Попробуем без ура-патриотизма и без слепого хейта разобраться: почему у нас есть сильные мозги, но почти нет «мышц», поможет ли Китай и что ждёт российский ИИ в ближайшие годы.
Старт вместе со всеми#
Россия не проспала революцию нейросетей. Ещё в 2020 году, за два года до ChatGPT, Сбер выложил в открытый доступ ruGPT-3 — одну из первых больших генеративных моделей для русского языка. Летом 2022 года Яндекс опубликовал YaLM на сто миллиардов параметров — на тот момент одну из крупнейших открытых языковых моделей в мире.
Когда осенью 2022 года вышел ChatGPT, ответ последовал быстро: весной 2023 года почти одновременно появились YandexGPT и GigaChat. Через несколько месяцев после американцев, под санкциями и без доступа к новому железу. Тогда разрыв с мировыми лидерами измерялся месяцами. Сейчас, когда передовые модели научились рассуждать, писать сложный код и работать как автономные агенты, многие эксперты оценивают его уже в годы. И причина не в том, что наши инженеры стали хуже.
Мозги: почему российский софт — это не «костыли»#
Скептики любят говорить, что российские нейросети — это перекрашенный американский код. Это не так. Обучение большой модели с нуля — огромная работа: сбор и очистка триллионов слов текста, собственная архитектура, месяцы обучения и тысячи итераций настройки. Сбер и Яндекс прошли этот путь сами. Они опираются на общие научные идеи — архитектуру трансформеров придумали не у нас, — но на те же статьи опираются и американцы, и китайцы.
При этом часть российских корпоративных моделей действительно строится на открытых зарубежных основах: некоторые компании берут, например, открытые китайские модели семейства Qwen и дообучают их под свои задачи. Это нормальная мировая практика, но к этой детали мы ещё вернёмся.
В чём сильны российские модели:
Понимание местного контекста. Попросите составить претензию к управляющей компании из-за прорыва трубы со ссылками на Жилищный кодекс, Гражданский кодекс и закон о защите прав потребителей. Зарубежная модель нередко выдаёт гладкий, но поверхностный текст, похожий на кальку с американского документа. Модели, обученные на российской правовой базе, в таких задачах часто отвечают точнее.
Экономия на русском языке. Нейросеть читает текст не словами, а кусочками — токенами. Модели, обученные в основном на английском, часто дробят русский текст на более мелкие части и тратят на ту же фразу больше токенов, а значит, работают дороже и медленнее. Российские модели изначально строили словарь под русский язык.
Массовость. Kandinsky и Шедеврум за пару лет стали бытовыми инструментами для миллионов людей, которые делают в них открытки, аватарки и иллюстрации. Яндекс перестроил поиск под ИИ: Нейро отвечает на вопрос сразу и со ссылками на источники. Сбер внедряет нейросети почти во все процессы — от оценки кредитов до генерации кода.
Корпоративный спрос. По опросам, подавляющее большинство крупных российских компаний уже так или иначе используют ИИ, а российский финтех по уровню цифровизации обгоняет многие европейские банки.
За всем этим стоит инженерная школа, которую нельзя купить или запретить санкциями: сильная математика, олимпиадная культура, МФТИ, ВШЭ, ИТМО, мехмат МГУ. Российские программисты годами побеждают на мировых чемпионатах, а многие специалисты ведущих мировых ИИ-лабораторий учились в этих аудиториях. Имея в разы меньшие бюджеты, чем Microsoft или Google, наши команды выдают продукты, которые не стыдно показать. Проблема не в людях. Проблема в том, на чём им приходится работать.
Железный голод: где брать чипы#
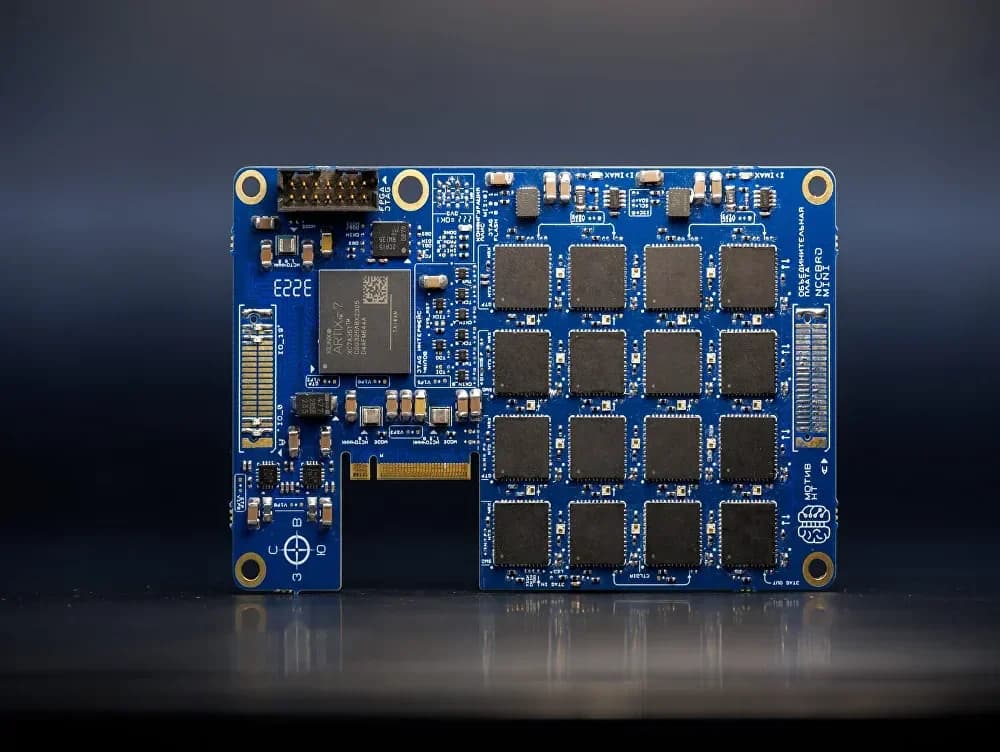
Искусственный интеллект живёт не в облаках, а на кремниевых пластинах — в залах размером с футбольное поле, которые потребляют электричество как небольшой город. Для обучения моделей уровня самых передовых нужны десятки, а то и сотни тысяч специализированных ускорителей. Флагманские чипы Nvidia стоят десятки тысяч долларов даже по официальной цене, а на сером рынке, по словам участников, цена за ускоритель может доходить до 40–50 тысяч долларов.
Россия отрезана от легальных поставок. Тайваньская TSMC не выпустит для российских компаний ни одного современного процессора: оборудование и программы для проектирования чипов там американские и нидерландские, и без разрешения Вашингтона через эту цепочку ничего не проходит.
Как выкручиваются российские компании:
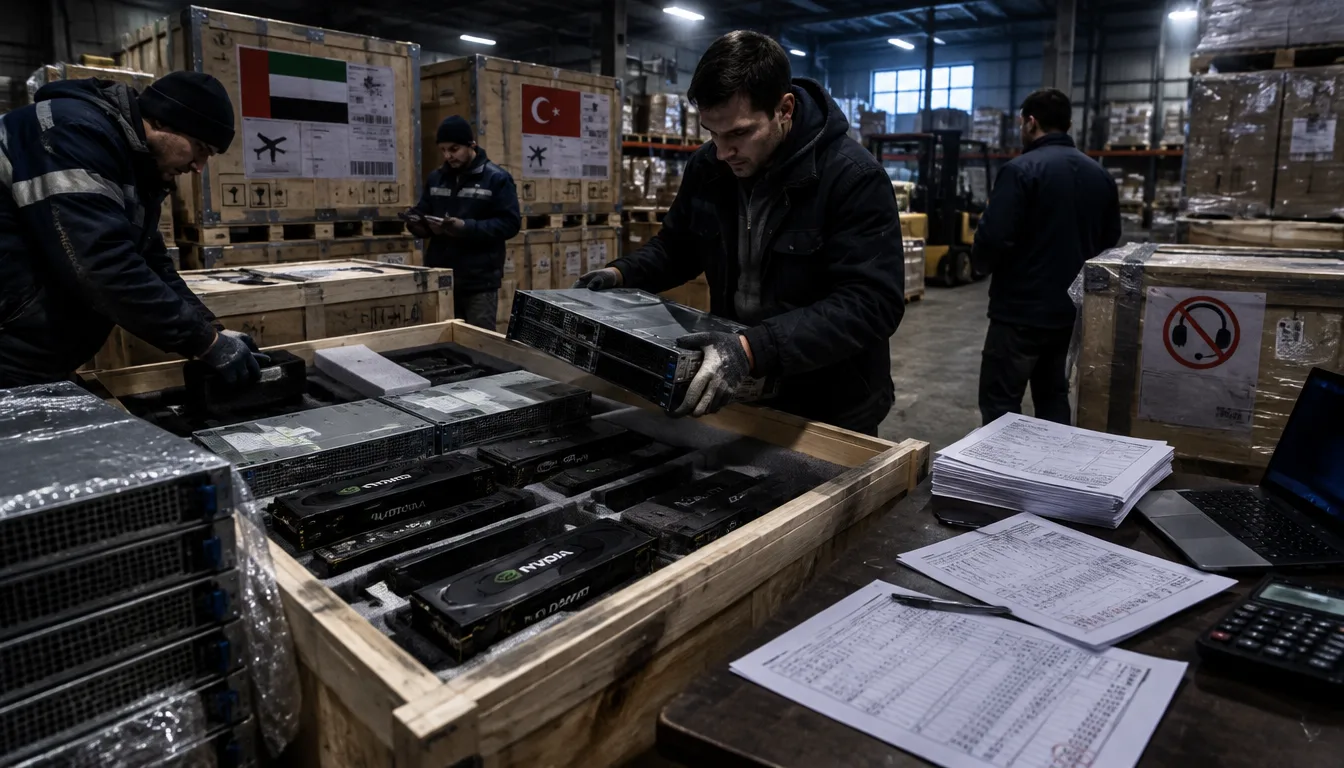
Серый импорт. Ускорители и серверы везут через ОАЭ, Турцию, страны Центральной Азии, иногда разбирая серверы и ввозя их по частям. Цена вырастает в полтора–три раза, официальной гарантии и поддержки нет, а каналы поставок могут закрыться в любой момент.
Аренда за рубежом. Часть компаний арендует вычислительные мощности в дружественных странах, но облачный провайдер может отключить клиента под давлением регуляторов.
Игровые видеокарты. Их проще купить и ввезти, и для небольших задач они годятся. Но у игровых карт меньше памяти, нет скоростных соединений для работы тысяч карт вместе, и они хуже переносят круглосуточную нагрузку. Собрать из них полноценную фабрику для обучения передовой модели — всё равно что строить грузовой самолёт из сотни дельтапланов.
Запасы. Основу российских вычислений составляют машины, купленные до 2022 года: суперкомпьютеры «Кристофари» у Сбера, «Червоненкис», «Галушкин» и «Ляпунов» у Яндекса. В начале 2020-х они входили в мировой рейтинг Top500, а «Червоненкис» был самым мощным в России. Но внутри у них в основном ускорители поколения A100, представленного ещё в 2020 году.
Здесь и кроется главная ловушка. Nvidia выпускает новое поколение каждые год-два, и каждое в задачах ИИ быстрее предыдущего в разы. При одинаковом бюджете американская компания с каждым годом получает всё больше вычислений, а российская работает на стареющем парке, который изнашивается и который нечем официально заменить. Разрыв растёт сам собой, даже если инженеры работают идеально.
Собственное производство не спасает. Процессоры «Эльбрус» и «Байкал» существуют, но выпускались они на той же TSMC, и после 2022 года этот путь закрылся. Зеленоградский «Микрон» работает по технологиям уровня 90 и 65 нанометров — это примерно уровень процессоров начала 2000-х. Для современных ИИ-ускорителей нужны 3–5 нанометров. Разница не в разы, а в поколениях. А машины для экстремальной ультрафиолетовой литографии, без которых передовую фабрику не построить, в мире делает одна компания — нидерландская ASML. Россия разрабатывает собственные литографы, но речь идёт о куда более старых технологиях и долгих сроках.
Есть и проблема энергии. Современный ИИ-кластер требует сотен мегаватт. Дешёвое электричество в России есть там, где не хватает инфраструктуры, связи и специалистов, а там, где всё это есть, сети уже перегружены.
Наш взгляд прост: параллельный импорт — это костыль. Нельзя построить цифровую сверхдержаву на видеокартах, купленных через посредников в Дубае. Если лазейки закроют жёстче, развитие российских моделей остановится на текущей точке. Оптимизировать код можно долго, но без вычислений модель умнее не станет.
Китайский спасательный круг, который может утопить#
Главная надежда — Китай. Он сам под американскими санкциями, сам строит чиповую индустрию и создаёт сильные модели вроде DeepSeek и Qwen. У Huawei есть собственные ИИ-ускорители серии Ascend, например Ascend 910B и более новые версии. Они слабее флагманов Nvidia, а программная экосистема для них заметно менее удобна, но это реальное железо.
Однако у китайского пути есть серьёзные ограничения.
Страх вторичных санкций. Крупные китайские компании и банки боятся потерять доступ к американскому и европейскому рынкам. Поэтому чувствительная техника идёт неохотно, через посредников и по завышенным ценам.
Им самим не хватает. Китайские производители не успевают выпускать столько ускорителей, сколько нужно внутреннему рынку, и местные технологические гиганты сами стоят в очереди за мощностями.
Собственные запреты. Китай ужесточает экспортный контроль — на редкоземельные материалы, ряд технологий и алгоритмы, которые считает стратегическими.
Зависимость в софте. Если российские модели строятся на открытых китайских основах, зависимость смещается в одну сторону не только в железе, но и в программах.
У этой ситуации есть поучительный прецедент. В конце 1960-х годов в СССР развивалось несколько собственных линеек компьютеров со своими архитектурами и школами. Тогда было принято решение, о котором до сих пор спорят историки техники: вместо развития своих разработок массово копировать американскую архитектуру IBM System/360. Так появились машины серии ЕС ЭВМ. В краткосрочной перспективе это казалось разумным, а в долгосрочной советская вычислительная техника стала догоняющей: каждое новое поколение IBM приходилось копировать заново, с отставанием на годы, а собственные школы угасли.
Менять американскую зависимость на китайскую — значит прыгать из огня да в полымя. Китай не отдаст свои самые передовые технологии: он продаст то, что выгодно продать, и ровно в том объёме, в каком выгодно. Это не злой умысел, а логика большой державы, которая играет за себя. Сотрудничать с Китаем нужно, но с пониманием, что это партнёр, а не спасатель.
Цифровой разрыв: ИИ для избранных#
Ещё один парадокс — глубокое расслоение. Есть Москва с беспилотными такси и умными камерами, есть Сбер, Т-Банк, Яндекс, крупный ретейл и телеком. И есть остальная страна. По данным статистики последних лет, искусственный интеллект использует лишь небольшая доля всех российских организаций — единицы процентов. Заводы, сельское хозяйство, ЖКХ и малый бизнес в регионах ИИ почти не видят.
Владелец сети автомоек в небольшом городе не станет внедрять ИИ-агента не из ретроградства. У него нет лишних денег, нет специалиста, который всё настроит, и главное — никто не показал ему, как нейросеть сэкономит деньги уже в понедельник утром. В районной больнице может не хватать даже компьютеров, а отчёты по-прежнему пишутся от руки.
Власти видят этот разрыв и пытаются ускорить внедрение административными мерами: национальные стратегии, отчётность госкомпаний, обсуждения обязательной предустановки российских цифровых сервисов и ИИ-помощников на смартфоны. Но технологии, навязанные сверху, вызывают раздражение и недоверие. Они приживаются через реальную пользу.
А полезных применений для регионов много: компьютерное зрение, которое по снимкам с дрона находит больные участки поля; системы, которые по звуку и вибрации предсказывают поломку насоса на водоканале; ассистент, который заполняет документацию за фельдшера в отдалённом посёлке. Для большинства таких задач не нужны гигантские модели — хватает небольших специализированных, которые работают и на скромном железе.
Есть и кадровая проблема. После 2022 года страну покинула значительная часть ИТ-специалистов — по разным оценкам, десятки тысяч человек, и среди них немало сильных инженеров машинного обучения. Мировые лаборатории предлагают зарплаты в сотни тысяч долларов в год и доступ к самым мощным кластерам планеты. Удержать человека, которому нужна возможность работать на передовом железе, становится всё сложнее.
Главная ошибка — думать, что ИИ-гонка решается только в лабораториях крупных корпораций. Самые большие выгоды получают те, кто массово применяет нейросети: тысячи небольших компаний, экономящих часы рутины каждый день. Если эта масса не включится, никакие суверенные модели не изменят экономику страны.
Что будет дальше#
Хоронить российский ИИ рано. Железный голод заставляет инженеров делать ставку на эффективность: сжатие моделей, дистилляцию, когда маленькая модель учится у большой, работу на скромном оборудовании. Мир уже убедился, что это не утешительный приз: когда DeepSeek показала сильную модель за малую долю привычного бюджета, это потрясло индустрию и на время обрушило акции Nvidia.
Важно и то, что значительная часть реальной пользы от ИИ — это не обучение гигантских моделей, а их применение. Чтобы обучить передовую модель, нужны сотни тысяч чипов, а чтобы запускать готовую сжатую модель для миллионов пользователей, — на порядки меньше. В прикладном ИИ для бизнеса, медицины, промышленности и образования у России есть реальный шанс быть сильной.
Но иллюзий быть не должно. Мы видим три сценария.
Прорыв. Появится новая архитектура вычислений или способ обучения, которому не нужен передовой американский кремний. Это маловероятно, но в истории технологий такое случалось.
Догоняющие. Российские модели будут отставать от мирового переднего края на пару лет, но останутся сильными локальными сервисами для своего языка, законов и бизнеса. Это самый реалистичный сценарий, и в нём нет ничего позорного.
Зависимость. Без своих чипов и нормального доступа к чужим российские модели постепенно превратятся в надстройки над чужими, прежде всего китайскими, основами. Формально свой ИИ будет, а по сути — нет.
Какой из них сбудется, зависит от трёх вещей: сумеет ли страна удержать и вырастить инженеров, найдёт ли устойчивый источник вычислений, не завязанный на одну лазейку, и сделает ли ИИ полезным не только Москве и крупным банкам, но и заводу в Челябинске, фермеру на Кубани и автомойке в небольшом городе. Если всё сойдётся, Россия может стать не лидером по размеру моделей, но одним из лидеров по их умному и экономному применению. Если нет — нас ждёт путь ЕС ЭВМ: вечное копирование чужого с опозданием на поколение.
А вы верите в «русский код», способный обойти санкции, или без собственных чипов нам суждено догонять?
Комментарии0
Войдите, чтобы участвовать в обсуждении.
ВойтиКомментариев пока нет
Начните обсуждение — ваш комментарий будет первым.